从谱图中确定分子结构,是有机合成、药物研发和材料研究中的基础环节。核磁共振、质谱、红外及紫外可见光谱分别反映原子连接、元素组成、官能团和电子环境等信息,但单一谱图通常只能提供部分线索。面对大量可能的分子结构,化学家需要综合不同证据,反复提出和检验结构假设。如何将这一过程转化为可扩展的计算方法,是自动化结构解析面临的重要问题。
围绕分子光谱预测与结构解析,莫凡洋团队与合作者近年来持续开展研究:提出Cycle-MS框架,将质谱到分子的逆向预测与正向谱图重建相结合;发展谱峰属性解耦学习模型ECDFormer,实现手性分子电子圆二色(ECD)光谱的高效预测与结构归因,并构建包含10,887个手性分子的开放计算光谱数据集CMCDS;建立基于结构邻域机制和图神经网络的红外特征峰预测方法。系列成果发表于Analytical Chemistry(2024, 96, 15550–15562)、Nature Computational Science(2025, 5, 234–244)、Journal of Chemical Information and Modeling(2026, 66, 2709–2718)等期刊。
近日,北京大学深圳研究生院科学智能学院莫凡洋、袁粒与韩国蔚山科学技术院Bartosz A. Grzybowski等团队合作提出多模态谱学驱动的有机分子结构解析新方法。研究将谱图中的结构线索与大规模分子结构知识相结合,构建“先提出假设、再约束修正”的两阶段学习框架,为利用人工智能辅助化学结构鉴定提供了新路径。本工作以“Hypothesis-and-Refinement Learning of Organic Structures From Multimodal Spectroscopic Data”为题于2026年9月11日在线发表于国际顶级化学期刊《德国应用化学》(Angewandte Chemie International Edition)。
研究团队将这一任务拆分为谱图驱动的候选生成与组成约束下的结构修正。第一阶段,SpectroMol模型融合多种谱学信息,提出候选分子结构;第二阶段,MS-Mol2Mol模型利用高分辨质谱提供的分子式、精确质量和不饱和度等约束,对候选结构进行修正。后者通过对ZINC20数据库中4亿个分子开展预训练,学习分子结构的统计规律。这样的分工,使相对稀缺的“结构—谱图”配对数据与规模更大的分子结构数据能够分别发挥作用。
为支持多模态谱学学习,团队构建了QM9SPIN数据集,涵盖红外、紫外可见、质谱、一维、二维核磁共振谱图开展研究。在QM9SPIN模拟基准上,使用完整多模态输入时,SpectroMol的首个预测结构与真实结构完全一致的比例(Top-1准确率)达到93.8%。针对模拟谱图与真实实验之间的差异,团队进一步从SDBS数据库整理了约1万个分子的实验数据,采用常规可获得的氢核磁共振、碳核磁共振和高分辨质谱信息进行迁移研究。经过实验数据微调,SpectroMol在实验测试中的首选结构准确率由直接迁移时的0.1%提高至28.6%,生成分子表示的有效性也明显改善。在此基础上,MS-Mol2Mol进一步利用质谱组成约束修正实验谱图预测结果,改善了候选结构的有效性、组成一致性、结构相似度及官能团识别。
该研究建立了连接多模态谱学证据与大规模分子结构知识的学习框架,展示了模拟预训练、实验数据适配与化学组成约束修正相结合的可行性,为高通量实验及自主化学研究中的结构鉴定提供了方法基础。
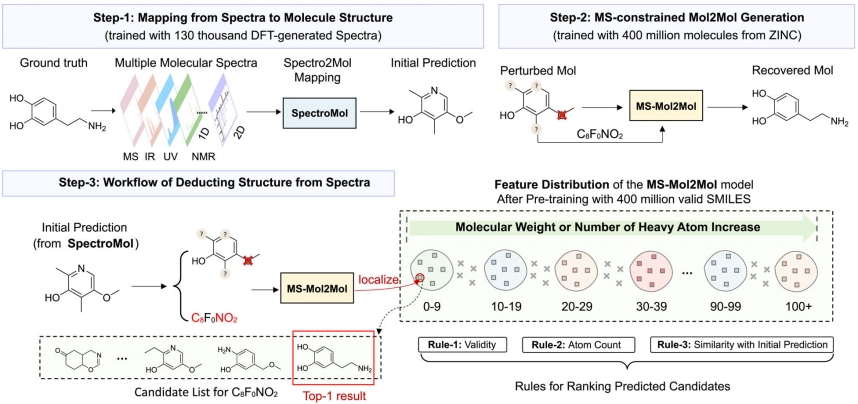
多模态谱学驱动的分子结构解析流程。SpectroMol根据谱图提出候选结构,MS-Mol2Mol结合大规模分子结构知识和质谱组成约束进行修正,再对候选结果筛选与排序。
北京大学材料科学与工程学院博士生刘丞军和计算机学院博士生晏志远为论文共同第一作者,袁粒助理教授、Bartosz A. Grzybowski教授和莫凡洋长聘副教授为共同通讯作者。该研究获得新一代人工智能国家科技重大专项、国家自然科学基金青年科学基金项目(A类)及面上项目等支持,并获得北京大学深圳研究生院、深圳市政府和韩国基础科学研究院的支持。北京大学高性能计算平台为模型训练提供了计算资源。
论文链接:10.1002/anie.9212238