北大深研院陈语谦团队与合作者研究成果发表于IEEE TPAMI、Science Advances和Nature Communications
生物系统中的信息天然是异构的。一个蛋白质可能同时与另一个蛋白质、DNA、RNA、多肽、小分子乃至金属离子发生相互作用;一个细胞可以被转录组、染色质可及性、空间位置等多种模态同时刻画;而一位患者,则由数以万计状态各异的细胞共同构成。过去几年,AI在这些层面各自取得了显著进展,但绝大多数模型仍然是“一事一议”的——为一种配体、一种模态、一个尺度专门设计一个模型。这带来两个结构性问题:方法难以复用,每出现一种新的数据就要从头搭建;模型学到的往往是特定数据集的捷径,而不是可迁移的生物学规律,一旦输入带有噪声或来自新的队列,性能便明显退化。
真正值得追问的问题是:能否建立一类统一的架构?北京大学深圳研究生院科学智能学院陈语谦团队与合作者近期在《IEEE Transactions on Pattern Analysis and Machine Intelligence》,《Science Advances》和《Nature Communications》上发表的三项成果。
从“相互作用建模”到“多模态整合”
团队在AI for Science领域的一个核心学术判断是:生物数据的难点不在于“量”,而在于“异构”;统一建模的关键,在于找到一个能够承载异构关系的“中间载体”,并让模型围绕这个载体去学习。近五年来,团队沿着两条线持续推进这一思路。
在分子相互作用层面,团队提出了面向蛋白质—配体结合亲和力预测的可解释异质相互作用图神经网络EHIGN(IEEE TPAMI,2024),主张模型的归纳偏置应当与结合的物理机制相匹配,并成功解释了奈玛特韦对不同新冠病毒变异株效力的变化;在抗原—抗体这一特殊的蛋白质—蛋白质相互作用场景中,与腾讯AI Lab合作提出了预训练抗体生成大语言模型PALM-H3(Nature Communications,2024),从头生成的抗体对多种新冠变异株的结合与中和能力获得体外实验验证。这两项工作共同回答了“结合得多强”与“如何设计结合物”的问题。
在细胞多模态层面,团队提出了模态枢纽自编码器Monae(Nature Communications,2024),利用模态间的调控关系构建跨模态特征图,结合对比学习与自适应聚类,在无配对信息的条件下同时实现多模态单细胞数据的整合与补全,其扩展版本进一步支持细胞类型特异marker基因与转录因子—靶基因网络的发现。
以上工作有一个共同点:图是承载异构关系的核心载体。但它们也都停留在同一条边界之内——图的拓扑一旦由输入数据确定,便在整个学习过程中保持固定;而模型所服务的尺度也是单一的。边界之外是什么?是预测结构带来的几何噪声,是不同配体模态截然不同的结合模式,是从细胞到患者之间缺失的那一级监督信号。团队近期的三项成果,正是跨越这条边界的尝试。
三项成果分别发表于IEEE TPAMI(2026年)、Science Advances(2026年 )和Nature Communications(2026年)。研究分别面向蛋白质结合位点的跨模态预测、单细胞数据的跨尺度参考映射,以及患者表型与单细胞转录组的桥接。
蛋白质图的拓扑演化:跨配体模态的统一结合位点预测
判断蛋白质表面哪些残基参与与配体的结合,是理解分子机制和开展药物设计的起点。现有结构方法通常把蛋白质表示为残基图,按空间距离连边后再传递信息。这一表示看似自然,却默认图的拓扑在整个网络中是固定的:预测结构中的局部坐标误差会变成错误的邻接关系;同一张图也难以同时适配蛋白质界面、核酸识别区、多肽接触位点和金属离子口袋这些尺度悬殊的作用模式。更根本的困难在于,结合位点由“功能关系”而非单纯“空间邻近”决定,而功能关系恰恰是输入结构中没有显式给出的信息。
DiConSite不要把由空间距离构建的初始图当作贯穿全网络的不变拓扑,而只把它当作“局部脚手架”。模型以蛋白质序列及其AI预测结构为输入,将蛋白质语言模型携带的序列语义与几何推理相结合;核心是隐式拓扑演化(LTE)模块——在网络深层依据学到的残基表示重新连边,让功能上耦合、空间上相隔较远的残基建立联系,同时弱化由结构噪声引入的虚假邻接。图不再只回答“谁离谁近”,而是回答“谁应当与谁交换信息”。为避免早期不可靠的拓扑被固化到深层,团队再以层次化拓扑蒸馏与动态课程蒸馏做“先演化、后对齐”,使序列语义通过拓扑进入几何推理,而不是简单拼接。
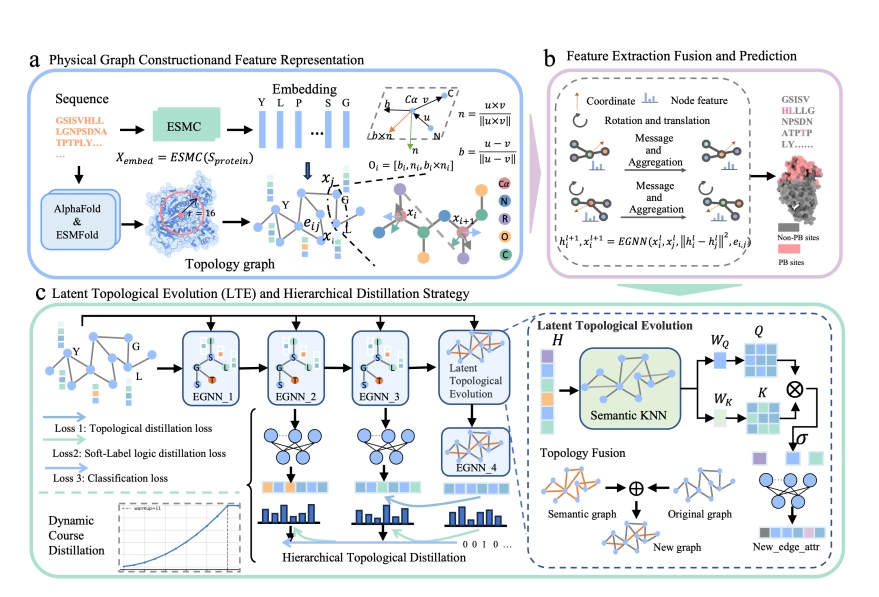
图1 DiConSite整体架构:物理图构建与特征表示、等变消息传递、隐式拓扑演化与层次化蒸馏
在覆盖蛋白质、多肽、DNA、RNA及三种金属离子等共九类配体的基准上,同一套架构无需针对任务重新设计,便取得了一致且多数最优的表现。更重要的是它的稳健性:在非结合态构象、低置信预测结构以及仅使用ESMFold结构时,静态图方法普遍明显退化,DiConSite则保持稳定。可解释性分析进一步显示,拓扑演化新引入的连接中近九成是长程连接,且在结合残基附近更密集——LTE补上的是“功能耦合”,而不是局部几何启发式。DiConSite因此不仅是一个结合位点预测器,更是一个可复用的残基级蛋白质相互作用分析框架:它把图的拓扑从输入端固定的先验,变成了网络内部可学习、可修正的中间变量,可以作为后续亲和力预测、界面设计乃至抗体生成的共享骨干。此论文第一作者为陈守智,通讯作者为科学智能学院田永鸿教授和陈语谦团队。
从细胞到个体:让一套表征贯通基因、细胞与患者
单细胞领域面临的,是另一种形式的“异构”。基因表达作为数值测量极易受批次效应影响,不同平台、不同实验室产生的“数值漂移”常常掩盖真实的生物学信号;与此同时,现有方法几乎只关注细胞层面的注释,基因层面和个体层面的参考映射没有统一的解决方案,而真正的临床问题——这位患者是否患癌、肿瘤来自哪里——恰恰是个体层面的。
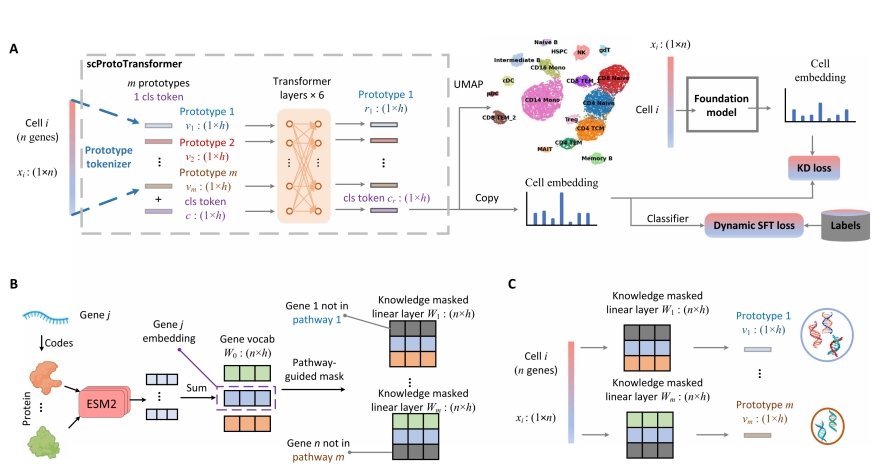
图2 scProtoTransformer跨分子、细胞与供体层级的可扩展参考映射
scProtoTransformer的回答是:不要直接在基因表达的数值上建模,而是先把它抽象成一组稳定的“生物学原型”。模型引入知识引导的原型分词器,依据通路知识把一个细胞的基因表达谱投影为数百个对应明确生物通路的原型token,再由Transformer学习原型之间的功能关联。由于原型刻画的是功能模式而非数值本身,这一步相当于一个“生物学归一化层”,在削弱批次效应的同时保留了生物语义,也使每个细胞的表征天然可以用通路来解释。在训练上,团队以冻结的单细胞基础模型为“导航员”进行知识蒸馏,使模型在仅使用约2%预训练数据的条件下继承基础模型的知识。由此,同一套表征支撑起三个层级的参考映射:基因嵌入用于基因功能注释,细胞嵌入用于跨批次、跨模态、跨疾病的细胞类型注释与整合,而把同一供体的全部细胞聚合起来,便得到个体层面的表征——在覆盖约400万个细胞的泛癌图谱上,模型不仅能判断供体的肿瘤状态与癌种,还能回溯样本中的恶性细胞。
scTransMIL则正面回答了“如何用患者级标签读懂单细胞”这一问题。临床上可靠获得的往往只有样本层面的诊断,而单细胞层面的恶性注释要么缺失,要么依赖拷贝数变异推断——后者在基因组稳定的肿瘤中信号微弱。团队与腾讯AI for Life Sciences Lab合作,把一个生物样本看作“一袋细胞”,以基于Transformer的多示例学习框架直接用样本级标签监督单细胞转录组的学习:全转录组编码器只保留基因的表达排序而非数值,从源头缓解批次效应;门控机制在聚合前过滤与诊断无关的细胞噪声,并为每个细胞给出肿瘤分数;自适应聚类损失则防止模型只盯住少数容易识别的阳性细胞。模型在汇聚104个公开数据集、30种癌症类型、约400万个细胞的泛癌图谱上训练,能够准确判断未见患者样本的肿瘤状态与癌种,包括转移瘤的原发组织来源,为“原发灶不明癌”的溯源提供了新工具。
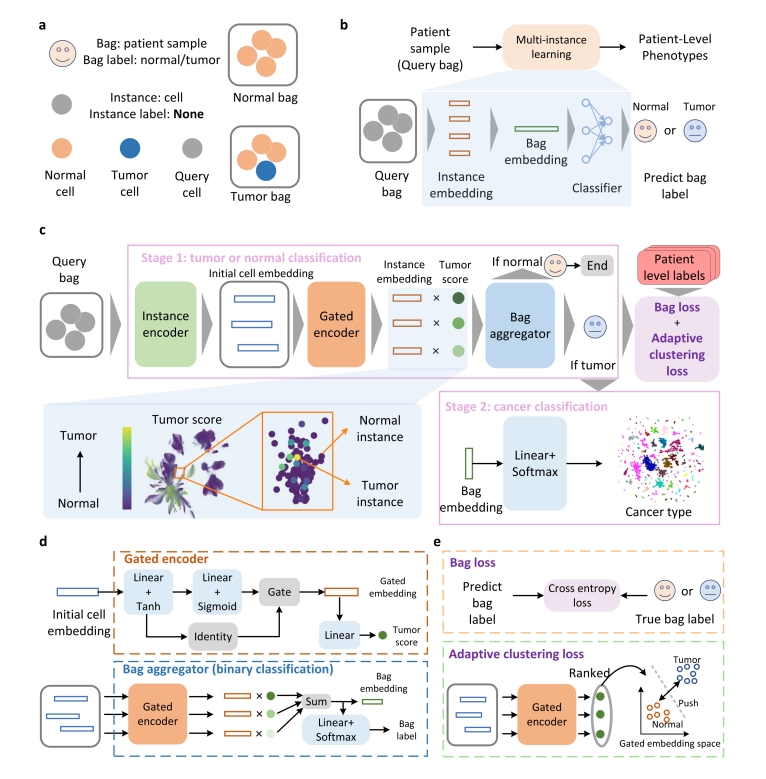
图3 scTransMIL桥接患者水平疾病状态与单细胞转录组
几个案例尤其能说明这一框架的价值。在一例甲状腺癌数据中,一份病理形态正常的癌旁样本被scTransMIL判为阳性,而所有对比方法均判为阴性;细胞级分析显示,高肿瘤分数恰好集中在原研究报道的处于癌前状态的滤泡上皮细胞中。在急性淋巴细胞白血病样本中,模型的注意力机制不仅找回了已知标志物,还识别出表达量在肿瘤与正常B细胞间并无差异、因而被传统差异分析遗漏的肿瘤B细胞标志基因BLK。面对训练集中不存在的急性髓系白血病,仅用二十余个样本级标签微调,模型即重建出造血分化轨迹,划分出与已知分化层级一致的恶性亚型,并在数百例患者的独立队列中验证了相应亚型的预后差异。
三项工作的内在统一:异构生物数据的统一表征
三项研究分别位于分子、细胞和个体三个尺度,解决的具体问题各不相同,但背后的方法论是同一个:面对异构数据,不为每一种模态手工设计一个模型,而是找到承载异构关系的正确“载体”,并让这个载体本身成为可学习的对象。在DiConSite中,这个载体是残基图的拓扑——它从固定的欧氏近邻演化为功能关系;在scProtoTransformer中,它是通路原型——基因表达被重新组织为跨批次、跨层级稳定的功能单元;在scTransMIL中,它是“样本即细胞袋”的多示例结构——患者标签得以沿着注意力传递到单个细胞与单个基因。
团队选择的是一条“从数据的异构性本身入手,用统一架构重构表征方式”的路径。这条路径不在某一个已经高度成熟的单一任务上做增量改进,而是致力于解决被“任务专用化”长期掩盖的共性问题:模型能否在换了模态、换了尺度之后依然成立。沿着这一方向,残基级的结合位点、细胞级的状态表征与患者级的疾病表型,有望被衔接进同一条可计算的链路——一个在蛋白质表面被识别出的结合位点,可以进一步与其所在细胞类型的表达状态、以及携带该状态的患者群体关联起来,为靶点发现与精准诊疗提供跨尺度的证据。
论文信息
1. DiConSite: A Unified Topology-Adaptive Architecture for Protein Binding Site Prediction Across Ligand Modalities
IEEE Transactions on Pattern Analysis and Machine Intelligence,2026年8月发表。
DOI:10.1109/TPAMI.2026.3720695
2. scProtoTransformer: Scalable reference mapping across molecules, cells, and donors
Science Advances,2026年8月发表。
DOI:10.1126/sciadv.aef0286
3. scTransMIL bridges patient-level disease states and single-cell transcriptomics for cancer screening and heterogeneity inference
Nature Communications,2026年9月发表。
DOI:10.1038/s41467-026-77538-5